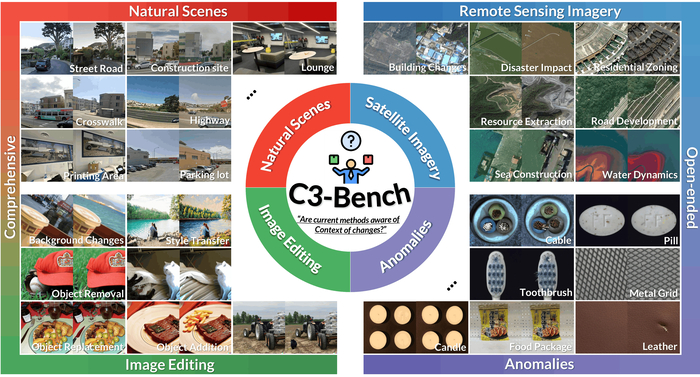
C3-Bench는 AI가 두 장의 이미지를 비교할 때 단순히 차이점을 나열하는 것을 넘어, 주어진 상황에서 중요한 변화를 식별하고 맥락에 맞게 설명하는 능력을 측정한다. 연구팀은 자연환경, 위성·항공 영상, 이미지 편집, 이상 탐지 등 4개 분야의 51개 상황과 4996쌍의 이미지로 평가체계를 구성했다. 해당 체계는 변화의 정확성, 구체성, 자연스러움, 상황 적합성을 종합적으로 평가한다. 연구팀이 사람과 GPT-5.2를 대상으로 성능을 비교한 결과, 전체 점수는 사람이 7.45점, GPT-5.2가 5.72점으로 나타났다. 이미지 순서를 뒤집었을 때 변화 방향을 일관되게 설명하는 가역성 평가에서도 사람은 93%의 정확도를 보였으나 GPT-5.2는 61%에 그쳤다. 반면 문장의 자연스러움 항목에서는 GPT-5.2가 8.53점으로 사람의 8.32점보다 높게 나타나, AI의 문장 생성 능력과 실제 상황 이해 능력 간의 차이를 확인했다. 김의환 교수는 이번 연구가 재난 감시, 자율주행 등 다양한 분야에서 AI의 성능을 개선하는 공통 기준으로 활용되기를 기대한다고 밝혔다. 이번 연구 결과는 지난 8일부터 12일까지 스웨덴 말뫼에서 열린 국제학술대회 'ECCV 2026'에서 채택됐다.
GIST, AI 문맥·영상 이해도 평가하는 'C3-Bench' 개발
광주과학기술원(GIST) 인공지능(AI)학과 김의환 교수 연구팀이 AI의 문맥 인식 및 영상 변화 이해도를 종합적으로 평가할 수 있는 새로운 기준인 '문맥 인식 변화 설명 평가체계(C3-Bench)'를 개발했다.
NEWN이 여러 언론사 보도를 교차 확인해 AI로 작성한 초안입니다. 편집·출처 원칙과 AI 작성 정책을 확인할 수 있습니다.